上一篇文章分享了一次数字人口播视频生成的实战,其中的配音使用 Qwen3-TTS 生成。效果不错,但在线生成有额度限制,日常更新还得考虑额度够不够用。
于是,这次决定把语音模型部署到自己的电脑上,在本地免费生成配音,不再受在线平台额度限制,同时通过声音克隆,让每次换稿后听起来仍像同一个人在说话。
手边的设备是一台 i5 处理器、16GB 内存、没有 NVIDIA 显卡的普通 Windows 笔记本。围绕这台电脑,我依次完成了模型筛选、安装、参考音频克隆、多轮调优和新文案验证,最终跑通了整个流程。
如果你也和我一样,手边只有一台普通电脑,想找一个能在本地运行、对中文友好、支持声音克隆的轻量语音模型,可以参考这次从安装到调优的完整实战。
我把这次已跑通的程序整理成了一个“本地配音工具”,提供可视化操作界面,方便导入参考录音、保存音色和生成配音。代码已上传 GitHub,大家可以下载后按步骤安装使用。
GitHub 地址:aicookcode/local-tts-lab
01 先看电脑,再筛模型
首先,需要根据电脑的硬件配置,选择能够在本机运行、支持参考音频克隆,且生成速度在可接受范围内的模型方案。
经过调研、对比和取舍,最终尝试了两条技术路线:Qwen 和 ZipVoice。
| 路线 | 实际使用的模型与运行方式 | 选择理由 |
|---|---|---|
| Qwen | Qwen3 TTS 12Hz 0.6B Base,社区 Q8 GGUF,llama.cpp b11707 | 使用 Windows CPU 二进制,不先搭建大型 PyTorch 环境 |
| ZipVoice | 先测 Distill INT8,再测 Distill FP32,通过 sherpa-onnx 推理 | 同一台电脑上容易比较精度、步数和参考录音 |
| ZipVoice 非蒸馏原版 | 额外安装用于对照,16 步和 32 步测试 | 检查更慢的原版是否更接近目标声音 |
| GPT SoVITS | 本轮没有安装和实测 | 缺少适合现有路线的环境与编译准备,先完成轻量方案 |
Qwen 和 ZipVoice 是两套不同的模型体系;ZipVoice 的蒸馏版、非蒸馏版,以及 INT8、FP32,则是同一家族中的版本或精度区别。
02 安装模型,启动本地配音工具
第一步:下载代码,安装 Python
打开上面的 GitHub 仓库,将代码下载到本地文件夹。后续操作均在该文件夹中进行。
安装 Python,并保留默认的 tkinter 组件,以便运行桌面界面。支持 Python 3.11 及以上版本。
Python 下载安装地址:https://www.python.org/downloads/
安装完成后,在保存代码的文件夹中打开命令终端,并执行以下命令进行验证:
py -3.13 --version
py -3.13 -c "import tkinter; print('tkinter OK')"
第一条命令应显示 Python 3.13 的版本号,第二条命令应输出 tkinter OK。
第二步:安装模型和运行环境
建议先留出 8GB 磁盘空间。同时安装 Qwen 和 ZipVoice,执行:
py -3.13 install_models.py --engine all如果只想先跑通 Qwen,可以改为:
py -3.13 install_models.py --engine qwen以后需要 ZipVoice,再补装:
py -3.13 install_models.py --engine zipvoice安装器会自动创建独立的 Python 环境、安装依赖、准备 FFmpeg,并下载模型、核对文件校验值。首次安装需要联网,本次 CPU 路线不需要安装 CUDA 或 PyTorch。
注意:Qwen 的 GGUF 是社区转换版,不是 Qwen 官方直接发布的 Windows 安装包。代码锁定了社区仓库的具体修订,配合文件哈希使用,而不是每次自动追最新版本。
第三步:启动工具,生成试听
安装完成后,双击:
启动本地配音.cmd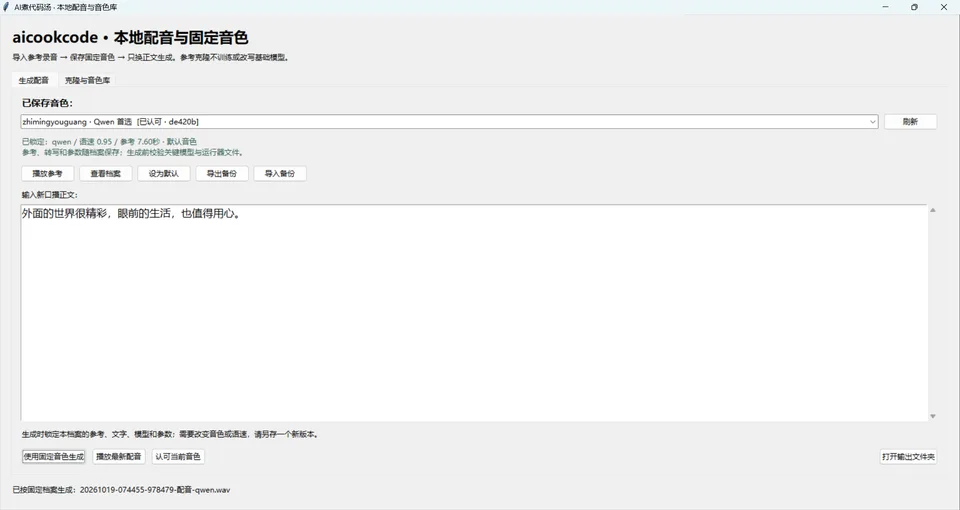
进入“生成配音”页面,选择已有的 Qwen 预设,输入一段短文:
外面的世界很精彩,眼前的生活,也值得用心。
点击“使用固定音色生成”,完成后点击“播放最新配音”。先确认短句能正常生成、没有漏读,再尝试长稿。
成品保存在工具目录下的 outputs 文件夹,同时保留正文、音频、日志和参数记录。模型下载齐全后,配音过程使用本地文件,不需要平台登录。
03 导入参考录音,克隆音色
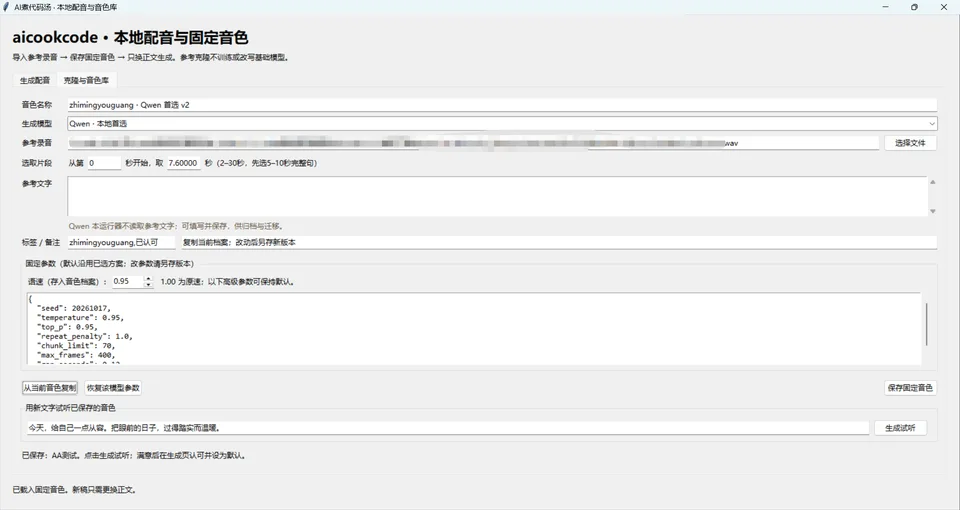
打开“克隆与音色库”,按照页面填写音色名称、选择模型、导入参考录音,再设置开始时间和截取长度。
参考尽量选一句完整、自然、没有背景音乐的话,先用约 5—10 秒测试。
保留默认参数,点击“保存固定音色”,再输入一段新文字,点击“生成试听”。完成后播放,检查有没有漏字、音色是否接近、表达是否自然。
04 Qwen 调优:从机械朗读到自然对话
第一轮 Qwen 没有明显杂音,但表达偏直,少了参考录音里的韵味。
调优时,我用同一段短文测试,先比较不同参考片段,再调整采样参数。每轮都保存配置和样音,方便回听对比,最终选中“对话候选”,配置名为 qwen-primary:
{
  "engine": "qwen",
  "seed": 20261017,
  "temperature": 0.95,
  "top_p": 0.95,
  "repeat_penalty": 1.0,
  "chunk_limit": 70,
  "max_frames": 400,
  "gap_seconds": 0.12,
  "default_speed": 0.95
}此外,top_k 固定为 50,min_p 为 0;CPU 推理和批处理均使用 6 个线程,设置 -ngl 0,并关闭配套模块的 GPU 卸载,全程由 CPU 完成推理。
选定声音后,仍觉得语速略快,于是保留同一份合成结果,在不改变音高的前提下,将语速轻微降至原来的 0.95 倍。工具已包含这一步,导出后无需重复减速处理。
日常使用不必反复填写这些参数,选择已保存的音色、替换正文即可。 如果需要更换参考录音或调整高级参数,可以从当前音色复制一份,另存为新版本,再用同一段文字试听,与旧版比较后决定是否采用。
音频效果对比
原样声音:
克隆后新文本生成的声音:
05 ZipVoice 调优:声音干净了,还要听像不像
ZipVoice 初始使用蒸馏 INT8、4 步配置,生成较快,但有杂音,音色也偏离参考。
早期尝试轻度降噪,底噪有所改善,声音仍然“不像”。因此,后续把重点放回模型精度、参考录音和生成参数。
随后换用 FP32,比较不同步数、引导值和参考片段,还补测了非蒸馏原版。最终版本参数:
{
  "engine": "zipvoice",
  "steps": 16,
  "guidance_scale": 3.0,
  "minimum_chars": 80,
  "maximum_chars": 200,
  "chunk_limit": 80,
  "gap_seconds": 0.12,
  "light_denoise": false,
  "default_speed": 0.98,
  "threads": 6
}
这次更慢的非蒸馏原版没有胜出,增加计算量也不保证更符合目标音色。工具已保留选中的默认参数配置,换自己的录音时,可以从这里开始测试。
音频效果对比
原样声音:
克隆后新文本生成的声音:
06 换一篇稿,验证声音能否复用
短样听着满意,还要换新稿再测,避免只对调参时的那段文字有效。
本次使用一篇未参与调参的完整口播,正文 177 个汉字,与已有的原样成品对照:
| 方案 | 音频时长 | 本地生成耗时 |
|---|---|---|
| 原有成品 | 47.73 秒 | 复用原文件 |
| Qwen 生成 | 约 50.53 秒 | 约 2 分钟 |
| ZipVoice 生成 | 约 49.49 秒 | 约 2 分 41 秒 |
原有成品:
Qwen 生成:
ZipVoice 生成:
以上是这台电脑和本次程序的实测结果。比较时先将试听音量调至接近,保留各自的自然停顿,不强行拉成相同时长。
自己验证时,也可以选一段未用于调参的稿件,在“生成配音”页选择已保存音色,生成后对照参考录音试听。重点检查四件事:读得对、像参考、表达自然、换稿后仍像同一个人。
07 保存音色,以后只换文案
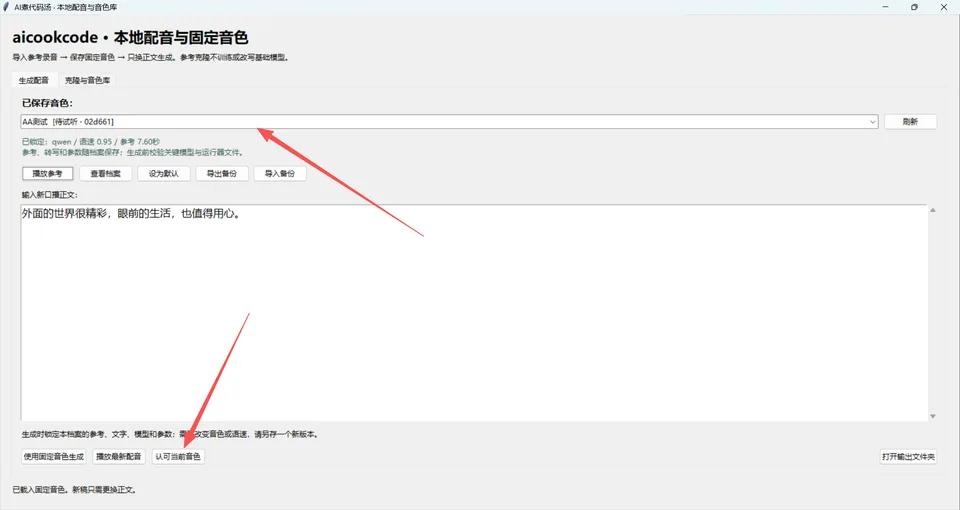
确认效果后,点击“认可当前音色”,再按需要“设为默认”。以后打开工具,选择音色、粘贴新稿、点击生成,就能沿用已保存的参考和参数。
本次最终保留 Qwen 作为首选,ZipVoice 作为非商业试听备选;本次使用的 ZipVoice 权重有非商业限制。
08 写在最后
从安装、声音克隆,到调优和新稿验证,我在这台普通笔记本上跑通了基于开源语音模型的本地固定音色配音流程。
对于需要持续配音的音视频账号,调好音色、保存配置后,日常只需换稿生成,就能把更多精力留给内容创作本身。
本次实战的需求和素材来自“知命有光”音视频账号。“本地配音工具”仍在持续开发,功能和界面也会逐步完善。后续会继续围绕实际创作需求,探索更省时、省力的音视频内容生产方法。感兴趣的话,欢迎持续关注“AI煮代码汤”。
也欢迎分享你的 AI 音视频创作经验,或推荐你用过的好工具。
继续保持连接.
如果这篇文章对你有帮助,可以用下面的方式继续关注。
RSS 订阅
按自己的节奏阅读更新没有算法排序,用 RSS 获取新文章,不错过每一次实践更新。
微信公众号·AI 煮代码汤
扫码关注,获取 AI、编程和开发实践的最新分享。