照片识别、成熟女声、免费额度、时长处理,一次真实制作的可复现记录。
最近测试了一套短视频制作流程:通过固定人物照片和自然的中文配音,无需真人出镜,就能让一位成熟、沉稳的东方女性像朋友一样,聊聊生活中的感悟,生成一条可供后期剪辑的数字人口播视频。
听起来只需要“上传照片,输入文案,点击生成”。实际做下来,验证码、图片识别、音色年龄感、免费额度、音频时长,每一项都可能把流程卡住。
这次我把AI助手用在了具体环节:梳理平台条件、整理口播稿、调整声音描述、操作生成页面、保存和核对文件。我负责确定人物方向、试听反馈和最终取舍。每到声音、文案这样的关键节点,先确认,再继续花积分生成视频。
经过几轮调整,我们最终跑通了文案设计 → Qwen3-TTS 配音 → Clipfly 照片口播 → 下载验收的流程,做出一条59.84秒、768×1024竖版、画面抽查未见平台水印的口播原片。两次 Clipfly 测试共用掉20赠送积分,现金支付为0。这里记录的是一次试用实测,不代表后续可以无限免费制作。
如果你也遇到过“声音太年轻”“还有积分却要求升级”“照片怎么换背景都不通过”,下面这些操作和排查方法,可以帮你少走一段弯路。
先看最终结果
使用紫色裙装人物照片,配以成熟普通话女声。保留完整口播内容,主要呈现嘴部和轻微面部动作,身体基本静止。
| 项目 | 实测结果 |
|---|---|
| 实际时长 | 59.84秒 |
| 画面规格 | 768×1024,3∶4竖版,25fps |
| 本条消耗 | 10赠送积分 |
| 水印检查 | 六个时间点抽查未见可见平台水印 |
这是已完成的口播原片。字幕、封面、配乐和平台发布,放在后续制作环节;本次没有把它们计入已完成成果。
一 先写清楚需求 再选择工具
我的目标并不是找一个功能最多的数字人平台,而是做出一个可以反复使用的内容角色。画面方向是东方成熟女性,声音要标准大陆普通话,温暖、沉稳、有厚度;语气像交谈,不像朗诵。第一阶段只需要15—30秒小样,声音和人物表现通过后,再尝试一分钟。
这份需求有一个关键点:允许上传自己的配音。只要声音能独立制作,就不必把人物表现、配音质量和字幕编辑全部押在一个平台上。声音不合适时,只改音频;图片不合适时,只换图片;口型效果不理想时,再比较视频工具。
把任务拆开之后,筛选条件也清楚了:能否登录,能否上传自有人物与音频,赠送额度能否覆盖一次真实生成,导出是否带水印,最终文件能否保存。先确认这些条件,比反复观看宣传样片更有用。
二 我们试过哪些路线 为什么最后换到 Clipfly
| 路线 | 这次实际遇到的情况 | 处理决定 |
|---|---|---|
| HeyGen | 本次使用的+86、+852号码均未能收到注册验证短信 | 停止在验证环节耗时,转向其他工具 |
| Hedra | 已登录并配置素材,账户为0积分,提交时要求升级 | 没有取得成片,不为尚未验证的效果先付费 |
| Mango AI | 拿到180积分并生成过两条测试片,但免费片带水印,外部音频权限又单独受限 | 完成初步验证,继续寻找可导入配音的替代工具 |
| MiniMax | 进入了声音测试路线,随后按我们的选择停止 | 没有采用它作为最终配音来源 |
| SadTalker、EchoMimic 公共演示 | 遇到报错或较长排队,未取得这次可用成片 | 作为研究路线保留,没有纳入成片流程 |
| Qwen3-TTS | 先得到自然度可接受的短样,后通过官方魔搭入口完成整篇配音 | 承担声音制作 |
| Clipfly | 本次账号收到20赠送积分,两次生成各扣10积分,均下载到视频 | 承担照片口播生成 |
D-ID曾作为备用方向,DreamFace、CapCut等也进入过候选清单。它们仍属于待比较候选,这次没有同条件成片可供判断。表里的注册与额度情况,也仅对应我们的测试账号和测试时点。
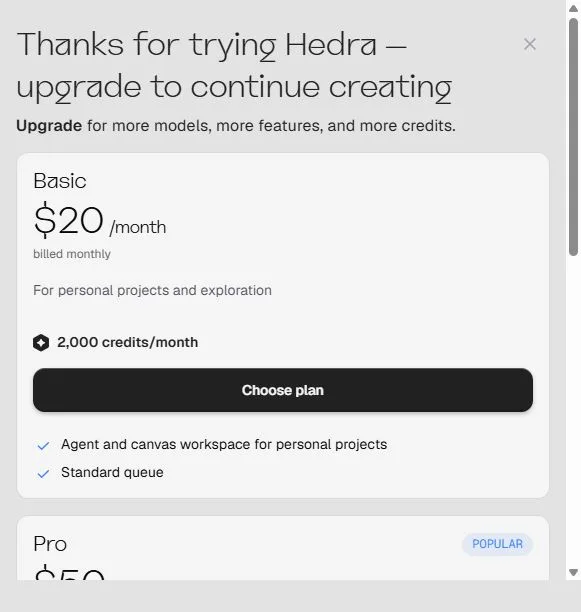
图1:Hedra当时在生成环节要求升级。完成注册,并不等于已经获得可用试用额度。截图中的价格是当时页面内容。
三 照片被拒 不要只盯着背景改
第一轮真正拖慢进度的,是自有人物照片上传后被拒。因为官方样例多是简单背景,我们一度怀疑问题出在背景太复杂,于是把人物背后改为浅暖灰纯色,又试过JPEG、PNG、缩小尺寸等方式。
结果是:纯色背景版本仍然被拒。后来换了另一张人物照片,却成功识别了;那张图依然有街景、灯光和其他背景细节。
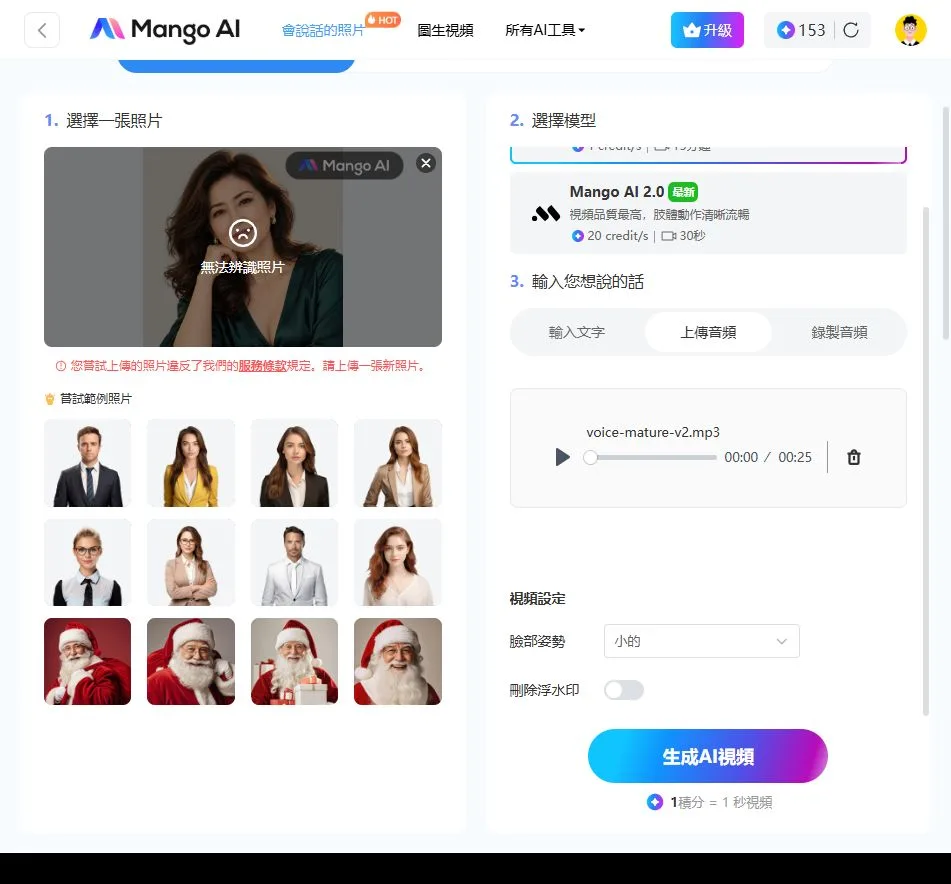
图2:换成纯色背景后仍无法识别。这个结果不能支持“只要背景纯色就能通过”的判断。
当时成功识别的一张图是768×1024的JPEG;之后另一张1086×1448的JPEG也被识别。它们说明我们应多准备候选图,却不足以证明“某个尺寸就是全部问题的根因”。内容、编码、压缩、尺寸和服务状态,都可能影响上传结果;我们没有取得服务端的明确拒绝原因。
更适合复现的做法,是先准备3—5张同一风格的人物候选图。每次只替换一个变量,并记录图片尺寸、格式、文件大小、是否识别成功。先用官方样例检查功能能否正常运行,再换成自己的图片。这样能区分“整条功能不可用”和“某份素材未通过”。
选图时,优先保证脸部清楚、嘴唇无遮挡、光线均匀。背景可以服务内容气质。我们的露台全身照适合表达从容生活,但人物脸部占比较小,不利于细看口型;如果下一轮专门比较嘴部细节,我会先试更近的半身构图。
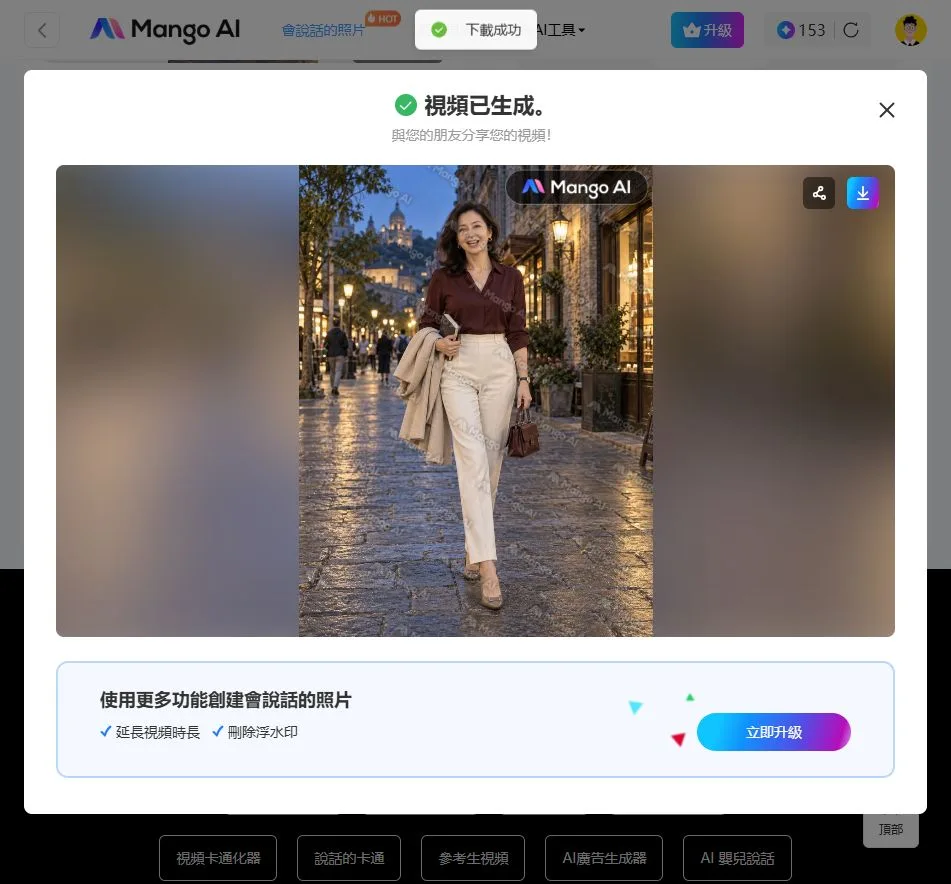
图3:换图后成功生成的自有人物测试片。复杂背景可以通过;画面中的Mango水印也清楚可见。
四 声音调试的关键 是先听十秒再做整篇
人物看上去成熟,声音却像二十多岁的年轻人,观众很容易觉得不协调。我们对配音的反馈,实际上分成了四层:口音是否合适,语气和停顿是否自然,声音有没有年龄感,整体是不是仍有明显的合成感。
最初试过Microsoft Edge语音合成的女声,做过降速、降调和轻微均衡调整,也试过其他音色。一版被指出台湾腔不合适;改回大陆普通话后,语气和停顿基本正常,但音色仍偏年轻。再往成熟、沉稳方向调整,短听似乎可以,放进完整视频里,又听出了明显AI味。
这段经历给我的启发是:降调可以改变听感,未必能做出可信的成熟人声。当基础音色不合适时,继续堆参数的收益有限。后来我们换到Qwen3-TTS的声音设计,先生成约10秒的短样,确认自然度,再把年龄感与醇厚感往上调整。
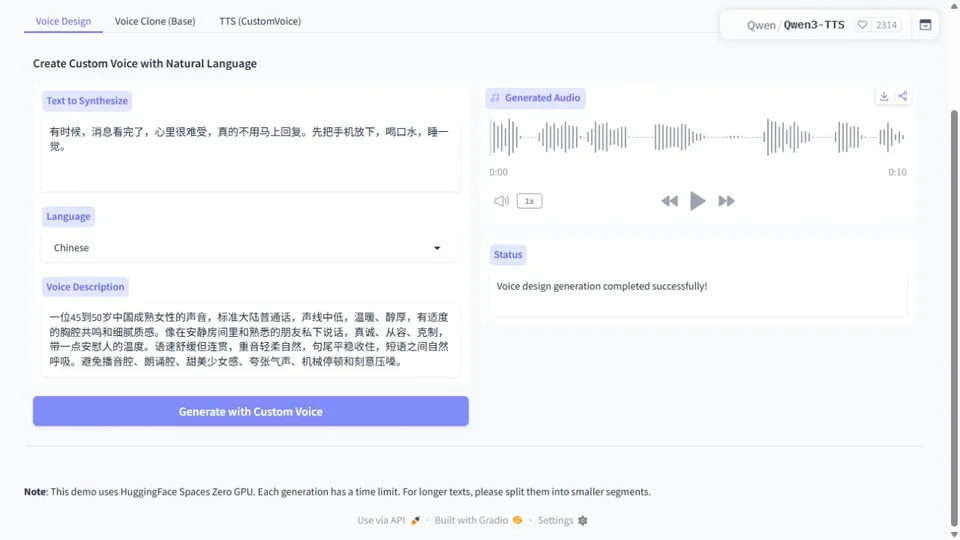
图4:先做短样,单独判断声音。这个阶段不需要消耗数字人视频生成积分。
最初我用演员声音形容想要的气质,随后把这种感受转译成了可操作的声音描述:年龄、口音、音高范围、共鸣、语速、情绪和交流场景。实际生成没有使用演员录音作克隆素材。
可以直接复用的声音描述
一位55岁左右、阅历丰富的中国女性,标准大陆普通话。声音有明显的成熟年龄感,声线中低,圆润、醇厚、饱满,带自然的胸腔共鸣和一点细微沙感,声带质感扎实,发声松弛而有支撑。像在傍晚安静的露台上,和相识多年的朋友私下交谈,真诚、温暖、沉静,从容地说出自己的体会。语速舒缓而连贯,约每秒四个汉字,句子内自然连接,停顿与换气顺畅,重音轻柔,句尾平稳收住。保持自然人声的细微变化。避免甜美少女感、台湾腔、播音朗诵腔、气息虚弱的老奶奶感、夸张气声、机械停顿和刻意压低嗓子。
这段提示词里的“55岁左右”,是创作方向,不是对生成声音年龄的鉴定。试听时可以这样判断:年龄感不够,先改声线与共鸣描述;停顿太碎,先改句子和标点;语速太快,先缩短内容或调整语速要求。每次集中修改一两项,保留上一版,方便对比。
五 一分钟口播 先给人一个具体场景
新人物图是一位穿紫色裙装、站在傍晚露台上的女性,气质安静、亲和。我们据此把主题确定为“留一点时间给自己”,内容围绕工作、家人、手机、茶和阅读展开,让画面与语言处在同一个生活场景里。
结构很简单:开头点出感受,中间写出日常困境,再给一个今天就能做的小行动,最后用品牌句收住。这比在一分钟里讲五六个道理,更容易保持交流感。
可直接复用的完整口播稿:
你有没有发现,到了这个年纪,最难得的,是终于能安安静静地陪一会儿自己。白天,工作要顾,家人要顾,总觉得忙完这一件,就能歇一歇。可事情总也做不完,留给自己的时间,反倒一推再推。今天,试着给自己留二十分钟吧。把手机放远一点,泡杯茶,翻几页喜欢的书,或者像现在这样,看看天色慢慢暗下来。有人找你,晚一点回复也可以。还有些事,明天再处理,也来得及。我们已经很会照顾别人了,往后的日子,也该多问问自己:累不累,想不想,喜不喜欢。愿你每天都能有一小段时间,不赶路,也不勉强自己。这里是知命有光,陪你把日子,过得从容一点。
这篇稿子约218个汉字。按照我们希望的舒缓节奏,生成音频实测为62.24秒。**字数只能用来估算时长,音频文件才是最终依据。**同样的文字,不同音色、停顿、语速,都会改变结果。
六 Qwen3-TTS 从输入到下载的实际操作
- **进入官方演示。**可以从Qwen3-TTS官方项目找到演示入口。我们先用过Hugging Face演示,后来切换到官方魔搭演示,并完成登录。
- **选择 Voice Design。**在 Text to Synthesize 中放入口播文字,把 Language 设为 Chinese,将上面的声音描述填入 Voice Description。
- **先生成短样。**截取两三句,点 Generate with Custom Voice。先听口音、音色、停顿,再决定是否继续。短样满意后,替换为完整稿件。
- **等待明确成功。**一分钟这轮,页面处理时间明显超过最初估算,数分钟后才出现音频。看到播放器和“Voice design generation completed successfully!”后,再认为任务完成。
- **下载后核对。**确认本地文件能播放,时长正确,开头和品牌结尾没有缺失;把文案、声音描述与音频按同一版本名保存。
我们在Hugging Face入口遇到过整篇、短段和参考音色模式的通用Error,页面没有解释具体原因。因此没有把失败武断归结为字数过长。魔搭登录后,整篇声音设计完成,原始音频是24kHz单声道WAV,时长62.24秒。
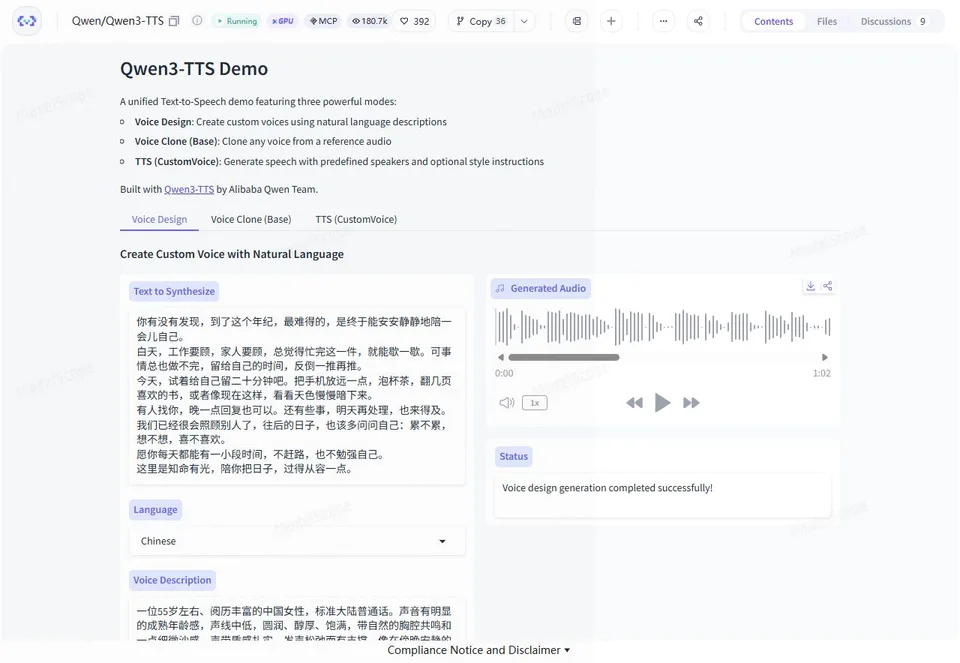
图5:魔搭入口整篇生成成功,播放器显示约1分02秒。声音先获确认,再进入视频生成。
下载时也有一个小插曲:自动点击下载没有立即触发保存,后续在本地下载目录取得了完整音频并核对为62.24秒。遇到类似情况,先确认文件是否已经落在下载目录,再核对大小、时长和内容,避免把旧音频误当作新版本上传。
长期固定角色音色,可以继续研究“先声音设计,再用已认可样本作参考”的方法。官方文档提供了相应流程。本次一分钟配音使用Voice Design,参考音色模式尚未成功;长期音色一致性还需单独验证,每次重新设计的声音可能变化。
七 还有129积分 为什么 Mango 仍然要求升级
在转向Clipfly之前,我们在Mango完成过两条测试:第一条用官方人物样例配上传音频,第二条用自己的照片配上传音频。账户从180积分降到153,再降到129。看起来还可以继续制作,下一次点击生成,却弹出了升级窗口。
两条Mango测试使用的是当时低消耗的1.0模型,界面显示1积分对应1秒视频;另一档2.0模型当时显示20积分/秒。相同积分余额,换一个模型,能生成的时长就可能完全不同。读者复现时,应先看自己所选模型旁的实际标价。
这里最容易看错的是升级的对象。弹窗写的是**“Upgrade to Upload / Record Audio”**,指向外部音频上传或录音功能,而不是简单地提示生成积分不足。
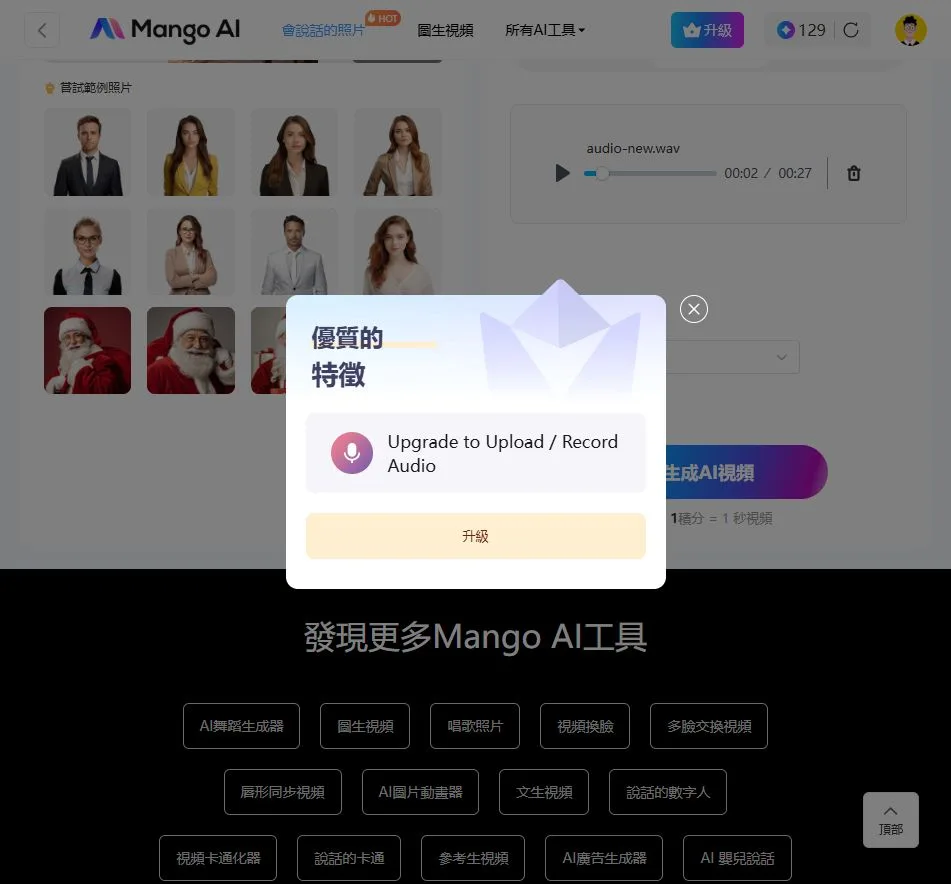
图6:右上角还有129积分,弹窗却要求升级音频上传权限。积分和功能次数是两套限制。
Mango官方套餐页的免费版说明列有180积分、平台水印,以及总计2次音频上传或录制;它不是“每天2次”。这与本次第三轮被阻断的现象相符。具体后台如何计数,我们没有读取,也没有继续反复试传。
所以,领取试用额度时,我现在会同时看四项:生成积分、外部素材导入次数、单次时长、导出权限。再有一个页面显示“免费”,也要看它具体免费的是编辑、生成、试听还是下载。开源模型本身可用,也不代表公共演示的算力和排队时间无限。
八 Clipfly 先完成27秒小样 再制作一分钟
我们在查资料时,看到Clipfly照片口播页面介绍了自备音频与无水印下载。但我没有仅凭宣传页就把它视为“永久免费”。真正继续的条件,是账号登录后显示赠送了20积分,工作台显示当前生成需要10积分。
第一轮使用当时选定的人物照片和27.52秒音频,先验证能否完成中文口播、能否下载、画面是否出现可见水印。这条生成后扣10积分,得到27.52秒、1086×1448的视频,余额10积分。随后才使用新照片和一分钟内容,避免把所有额度耗在声音尚未确认的版本上。
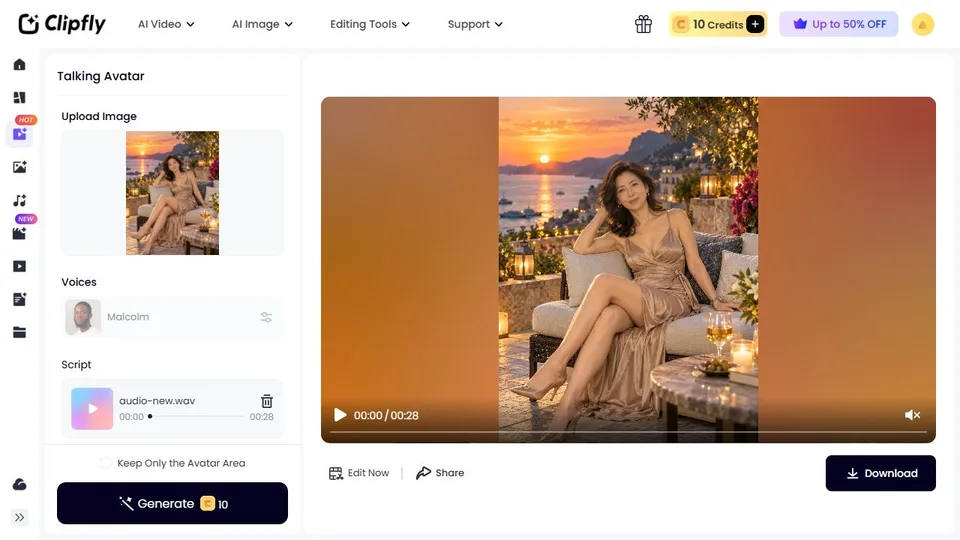
图7:27秒小样跑通后,才进入一分钟版本。页面仍显示10积分,可继续一次本次标价的生成。
播放27.52秒小样
它与一分钟版使用不同照片、不同口播内容,展示的是工作流先后两个阶段,并非严格的同条件画质对比。
照片口播工作台的操作顺序
- 进入Talking Avatar。在Upload Image区域点击上传,选择Upload from Device。
- 选中人物图片,等待上传及人脸识别完成,再点击Confirm。核对左侧缩略图确实变成新照片,避免仍用上一条素材。
- 点击Upload Voice Audio,上传已确认的配音文件。页面有英文脚本提示,但这次走的是音频上传入口,实际生成了中文口播。
- 核对音频文件名和显示时长。上传后如果又回到空白脚本框,说明素材没有稳定保留,先排查,不要直接点Generate。
- 我们保留完整人物画面,没有勾选Keep Only the Avatar Area。点Generate前,再核对图片、配音与积分标价。
- 第二次生成会出现Generate Again确认,说明新任务会替换当前预览、旧内容可在Workspace查找。我们先保存旧片,再确认新任务。
- 出现Generating后等待;出现新预览与Download按钮后下载。最后检查本地文件,不能只凭提交提示判断成片成功。
九 62.24秒上传失败 我们怎样保住全部口播
一分钟版出现了一个新问题:62.24秒WAV上传后没有保留在工作台,转成相同内容的MP3也一样。页面没有给出明确原因,所以我们没有把“60秒上限”写成已经证实的平台通用规则。
接着做了一个很小的验证:保留原始文件,制作一个59.8秒上传副本。处理时没有删除任何一句话,没有整体加速,也没有改变音高,只缩短八处较长停顿的中间空白,总计约2.44秒。这一版被工作台接受了。
想在剪辑软件里复现,可以导入配音并放大波形,在较长的句间停顿中间分割,只删除一小段安静区域;每处都保留自然换气。边听边改,目标先控制在59—60秒内,而不是为了凑时长切掉词尾。导出WAV或MP3后,再从头到尾听一遍。原始音频和缩短后的上传副本都保存在素材包里,便于对照。
原配音 62.24秒
上传副本 约59.8秒
这里可以得到的结论是:**在这次账号、这条素材、这个入口里,60秒内副本成功,62秒版本未成功。**后续遇到同类问题,值得优先检查时长,但不必把所有上传失败都归因于它。
十 成片下载后 我们实际验收了什么
第二条视频使用剩余10积分完成,余额变为0。文件实测59.84秒,768×1024、25fps,H.264视频和AAC音轨。上传副本约59.8秒,最终文件略有差异,记录时分别保留两者,不用“约一分钟”替代全部参数。
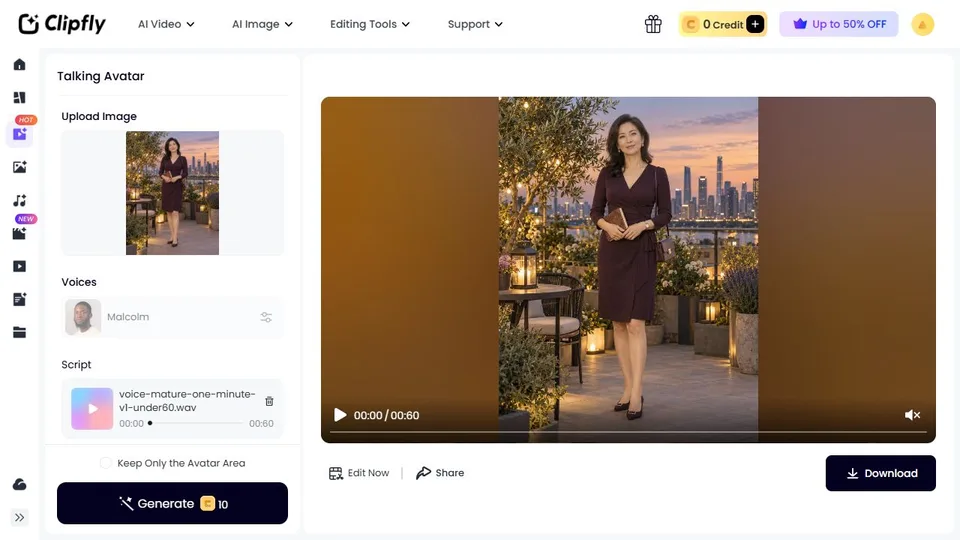
图8:一分钟版生成完成。照片、音频副本与新预览对应,余额为0,视频已下载到本地。
我们检查了开头、结尾、多个中间时间点,核对画面没有换错人物,口播内容完整,音轨与上传副本一致。六个抽查时间点没有看到可见平台水印。这些检查能够确认文件可用,但嘴形是否足够自然,还需要按正常播放速度听看,尤其留意闭嘴、开口、停顿与眨眼。
这条成片的特点也很明确:身体基本静止,变化主要在嘴部和轻微面部表情,完成了“让照片开口说话”的验证。输出是3∶4竖版,分辨率尚未达到1080p。全身构图保留了露台氛围,代价是脸部细节在手机屏幕上偏小。如果想要更多肢体表演或更近的口型细节,需要另做素材和效果测试。
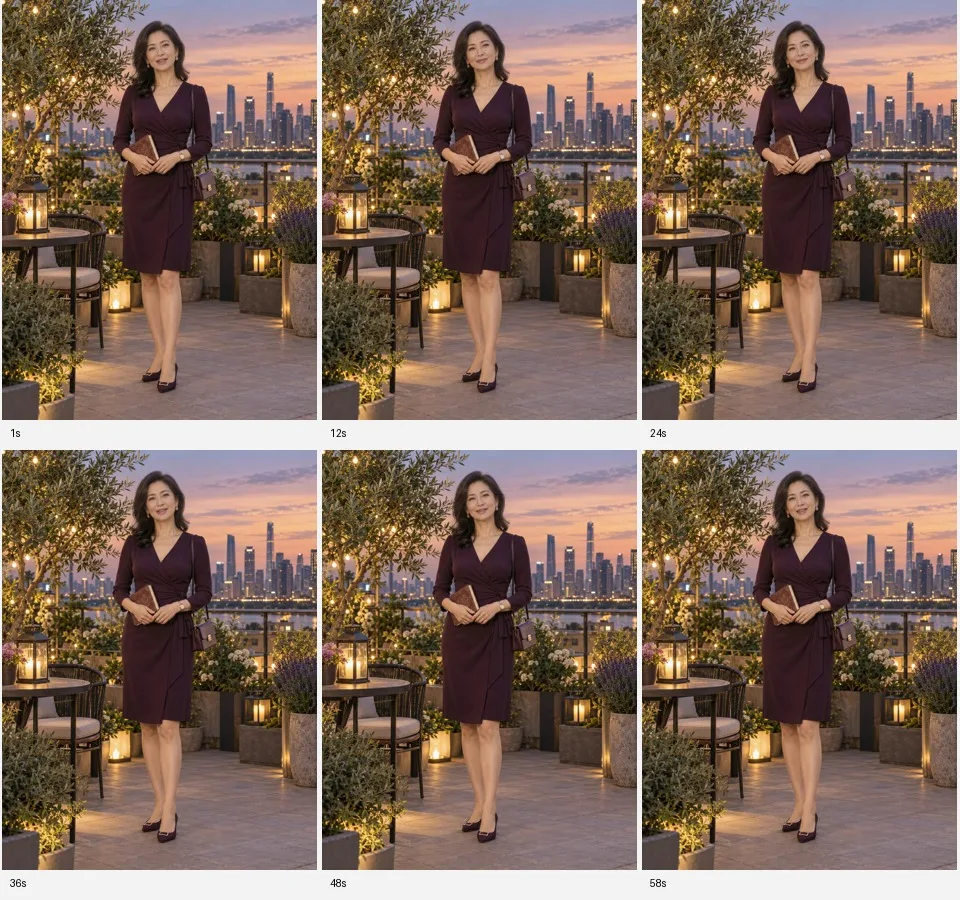
图9:最终成片的六帧抽查,来自真实视频截帧。它用于检查人物与背景一致性,口型同步仍应播放判断。
十一 下一步在剪映完成字幕与发布准备
到这里,已经实测完成的是照片口播原片。下面是接到剪映继续制作的操作方案,不是本次已经做完的字幕成品。
- **导入口播视频。**先检查原声是否完整,再确定发布画布。若需要9∶16竖屏,可以尝试背景填充或适度裁切;保留全身时检查脚部和头部是否出框。把3∶4拉伸成9∶16会改变人物比例,应避免。
- **生成并校对字幕。**使用当前版本的字幕识别功能,或手动按已定稿文案输入。优先核对专有名称、漏字与断句。不同版本的功能名称和付费状态,以实际界面为准。
- **控制阅读负担。**每行尽量保持一句短意群,白字加细暗色描边即可;用手机预览字幕与平台按钮的位置关系,不遮挡脸部,也不要贴底。
- **最后再考虑配乐。**先确认纯人声已经自然。需要音乐时轻声铺底,听清句尾和换气,再决定音量。
- **制作标题与封面。**这条视频采用“别再等忙完了,才想起自己”作为标题方向,话题与内容保持一致。
“没有可见平台水印”与“是否含AI生成内容”是不同的事情。发布这类数字人口播时,使用平台提供的AI内容声明,保留生成信息。抖音官方公告提供了主动标识说明;实际发布入口以当时客户端为准。
十二 把这条流程变成下次能直接用的工作习惯
每条内容都保留五份材料:人物原图、最终文案、声音描述、获认可的原始配音、实际上传平台的音频副本。生成完成后,再加入视频原片和一张成功页面截图。这样发现声音或口型问题时,可以定位是哪一版素材,而不是凭印象重做。
| 遇到的问题 | 先检查什么 | 下一步怎么做 |
|---|---|---|
| 注册卡住 | 验证方式是否可用 | 保留当前结果,转向能实际进入工作台的候选 |
| 照片被拒 | 官方样例是否可用,其他候选图能否识别 | 逐项检查尺寸、格式、清晰度,避免同时改很多变量 |
| 声音太年轻 | 基础音色是否合适,是否只是做了降调 | 先换声音设计方向,再用短样比较 |
| 还有积分却弹升级 | 弹窗写的是哪项权限 | 核对音频上传次数、时长、水印和下载权益 |
| 音频上传后消失 | 文件是否可播放,格式与真实时长是否合适 | 保留原件,用格式副本或少量停顿调整做对照 |
| 提交后长时间等待 | 页面仍在处理还是已经报错 | 保留任务,等明确结果,不重复扣积分提交 |
| 看起来有成片却找不到文件 | 下载目录、文件大小、播放时长 | 核对当前版本,再归档到项目文件夹 |
这次的单条流程已经跑通,长期批量生产还需要继续验证音色一致性、人物自然度、失败率与每条成本。下一步最值得做的,是固定一张人物图和一个认可的声音样本,用几条不同文案测试它们能否稳定工作。
把本文的声音描述、额度检查方法和问题排查表存下来。下次做AI数字人时,可以先用十秒声音小样和一条短视频验证,再投入完整内容。如果身边有人正卡在“图片传不上去”或“声音不自然”,也可以把这份实测过程分享给他。
继续保持连接.
如果这篇文章对你有帮助,可以用下面的方式继续关注。
RSS 订阅
按自己的节奏阅读更新没有算法排序,用 RSS 获取新文章,不错过每一次实践更新。
微信公众号·AI 煮代码汤
扫码关注,获取 AI、编程和开发实践的最新分享。