做一条三分钟的视频,配音这三分钟,比剪辑还折腾人。
念错一句,重来。背景有杂音,重来。好不容易录完,文案要修改,还得重来。
如果能让 AI 克隆自己的声音,往后只给文案,配音自动生成,就方便多了。
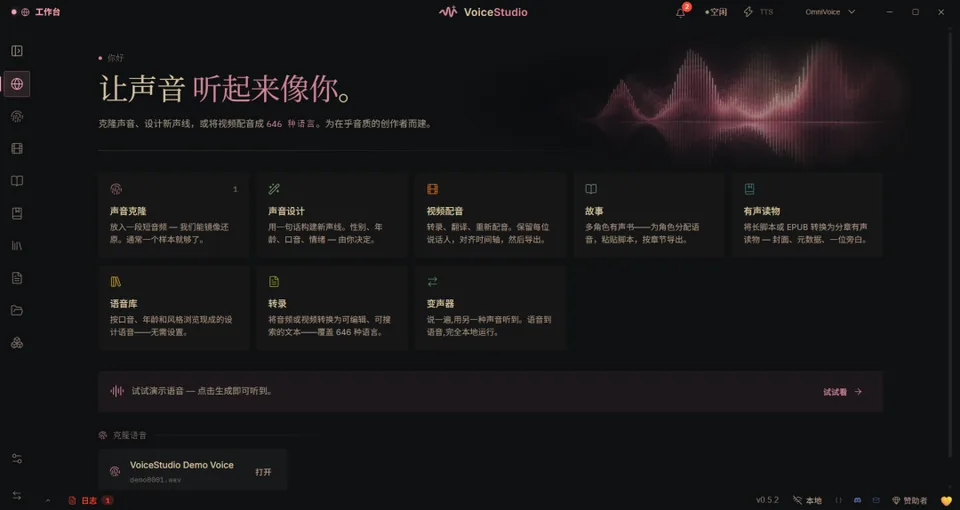
VoiceStudio,就是能做这件事的工具而且,它能做的还不止配音:给视频换一种语言、把文章变成有声读物、给故事里的不同角色安排不同声音,甚至直接把你说的话变成文字,都可以在里面完成。
它是一款免费、开源的电脑软件,自带中文界面。不注册账号、不订阅会员、没有额度限制,数据保存在你的电脑,Mac、Windows、Linux 都支持安装使用。
先说说它跟云端方案的区别
市面上做语音克隆最出名的是 ElevenLabs 这类云端服务,效果确实顶,但按量收费,克隆一个声音、生成一小时音频,账单肉眼可见。而且你的声音样本要上传到人家服务器——声音也是生物特征信息,传出去就收不回来了。
VoiceStudio 走的是另一条路:模型跑在你自己电脑上。声音样本不出门,不花一分钱,没有用量上限。代价是效果天花板比顶级云端服务低一档,而且吃配置。但对大多数个人创作者来说——做视频配音、播客、有声书——本地模型的效果已经完全够用,省下的订阅费是实打实的。
一句话总结:要极致效果、商用大制作,选云端;要免费、隐私、日常够用,选 VoiceStudio。
它能帮你干点啥
先看几个最容易用上的场景。
声音克隆
给它一小段你的录音,再输入新的文字,它就会用接近你音色的声音,把文字念出来。
克隆效果好不好,七分看录音质量。录样本时注意这几点:
- 找个安静的环境,关掉风扇和空调,手机开飞行模式
- 用尽量好的麦克风,实在没有,手机在衣柜里录都比在客厅强(衣服吸音)
- 录 1-3 分钟,内容选有起伏的:新闻播报+日常对话混着来,别全程一个调
- 语速自然,别刻意字正腔圆——你平时怎么说话就怎么录,克隆出来才像你
样本录得好,生成的配音自然度会高一个档次。反过来,拿一段地铁里录的语音去克隆,神仙也救不回来。
声音设计
不想用自己的声音,可以试试“声音设计”。
你可以指定或描述性别、年龄、音高、口音、情绪这些特点,比如青年女声、中年男声,或者带点口音的讲述声。
做产品介绍、故事旁白、知识讲解的时候,多试几种声音,挑最搭内容的那一个。建议一次生成 3-5 个候选,听一遍再定——文字描述和实际听感之间总有差距,耳朵收货最靠谱。
视频翻译配音
导入一段视频,它会先识别对话内容,翻译成你要的语言,再生成新的配音,最后导出视频。
官方表示支持646 种语言,但具体能用哪些、效果好不好,得看你选的语音模型。视频翻译也有各自的语言范围。本文没有覆盖全部语言组合的对照测试,选择前应使用自己的片段试听和校对。
一个实用技巧:翻译前先检查自动识别的字幕有没有错。字幕错了,后面翻译和配音全跟着错,白跑一趟。花两分钟校对字幕,能省半小时返工。
多角色配音
它支持多角色配音,能分别给旁白、主角、配角安排不同的声音。生成出来的内容,就有了不同人物轮流开口的感觉,做有声书、小说多人配音最合适。
做有声书时,建议先把文案按角色拆好,标出哪段是谁说的,一次性批量生成,比一段一段点效率高得多。对话密集的小说章节,多角色配音的提升尤其明显——单人播讲和多人演播,听感完全是两个世界。
转录和听写
它还带听写功能,能把你说的话直接转成文字。
在桌面任意位置按住对应快捷键说话,松开后文字会输入到当前聚焦的应用中。
写长消息、记灵感、口述文章初稿,这个功能都非常实用。很多人低估了听写:口述的速度是打字的 3 倍左右,写初稿、列提纲时先说后改,效率提升非常直观。
怎么上手
系统要求
安装之前先看一下电脑配置。它对硬件有点要求,配置越高越顺畅;普通配置也能跑,就是速度会慢一点。
| 环境 | 官方当前说明 | 使用前需要确认 |
|---|---|---|
| Windows 10/11 x64 | 支持 CPU 与所选 GPU 加速路径 | 安装包架构、显卡驱动和引擎支持 |
| Apple Silicon Mac | 支持 Metal / MPS | 所选模型的内存需求 |
| Linux x64 | 支持 CPU / CUDA,其他加速依引擎而定 | 发行包和驱动兼容性 |
| Intel Mac | 当前桌面界面可连接远程后端,能力有限 | 后端在哪里运行,音频会发送到哪里 |
| 内存、磁盘与模型 | 不同引擎和模型需求不同 | 按所选模型预留空间,先做短样本测试 |
这张表是平台选择参考,不是所有模型的统一最低配置。官方当前按平台和引擎区分支持情况;CPU 路径可用但速度取决于模型。先检查安装版本,再用短文本测生成时间、内存和听感。
下载
根据电脑系统,去官网下载对应安装包。
安装
点击安装包,正常安装即可。第一次安装启动会先建一个托管 Python 环境,再下载默认模型,需要花一些时间。之后每次打开都复用,不用重下。
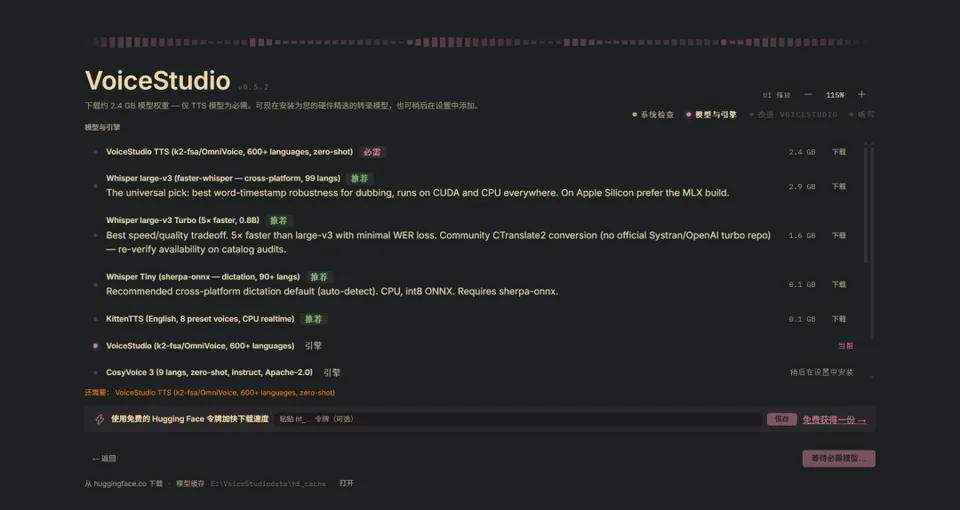
VoiceStudio 主要靠两类模型干活,安装时按需下载就行。
TTS(Text-to-Speech 文本转语音)
ASR(Automatic Speech Recognition 自动识别语音,即语音转文本)
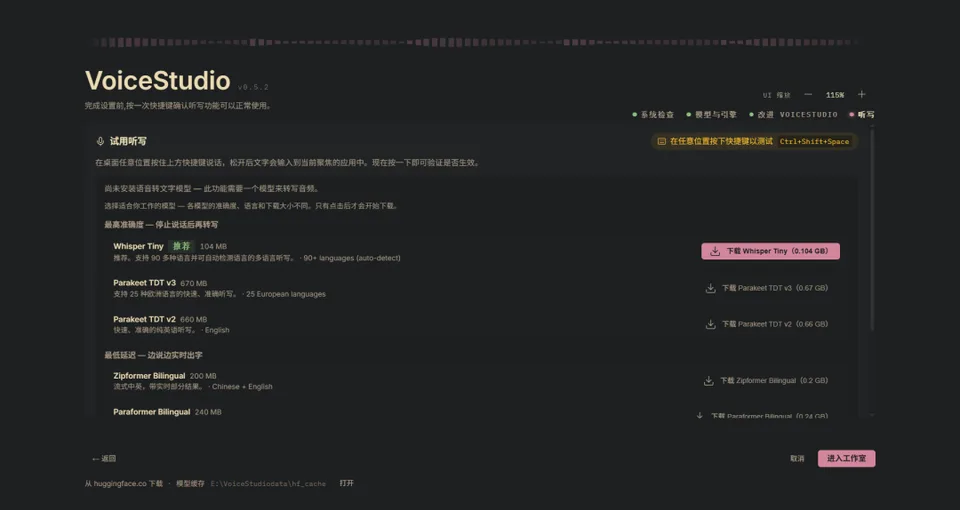
如果你主要做配音,优先保证 TTS 模型的质量;如果主要用听写和转录,ASR 模型更重要。两个都要,就都下——硬盘够大就行。
源码项目
想折腾源码,也可以自己去 GitHub 拉代码:
GitHub 仓库:https://github.com/debpalash/VoiceStudio官方 README 里还有更详细的部署说明,需要可以查看。
用三句话选择模型,而不是先下载全部模型
参考录音长度与格式应按所选引擎要求准备,不把同一份样本规则套到所有模型上。先准备自己有权使用、没有背景音乐的录音,再使用固定文本比较结果:
你好,这是第一段声音测试。
请核对 2026 年、3.5 和 24 小时的读法。
这一句先停一下,再继续说完。
对每个候选模型记录生成耗时、峰值内存、数字读音、停顿和音色相似程度。相同设备、文本和参考录音下比较才有意义;不要仅凭“支持语言数量”判断中文配音质量。
本文侧重 VoiceStudio 的功能与选择路径。想看具体机器上的安装截图、调参和换稿过程,可以转到 i5、16GB 内存的 Qwen3-TTS 与 ZipVoice 实战;音频准备好后,再接 照片数字人口播视频流程。
平台、引擎与安装方式以 VoiceStudio 官方说明 为准。
一条必须划的线:声音伦理
语音克隆技术越好,越要说清楚边界:只克隆自己的声音,或者拿到明确授权的声音。
用别人的声音做配音、做恶搞视频,哪怕觉得“只是玩玩”,也可能踩到法律红线。各国对声音权的保护越来越严,国内也有相关的肖像权、声音权诉讼先例。技术无罪,但用技术冒充他人身份,就是另一回事了。
自己用的话也建议留个心眼:克隆样本别发到公开的地方,免得被别人拿去乱用。
适合谁
适合做播客、有声书、课程音频的人。尤其是不想把所有原始音频都传到云平台时,本地优先会让人安心一点。
也适合愿意折腾本地 AI 工具的人。比如你想做视频本地化,希望把转录、翻译、配音、字幕放到一条流水线里。
还适合预算有限的学生和独立创作者:零成本、无额度限制,半夜三点想生成配音,不用心疼调用次数。
写在最后
如果你也对本地语音克隆、AI 配音、有声书生成感兴趣,不妨试试这个工具。
它的定位很清楚:不跟云端大厂拼极限效果,而是把“够用且好用”的语音 AI 交到每个人手里,免费、本地、没套路。对创作者来说,这就够了。
内容更新:
继续保持连接.
如果这篇文章对你有帮助,可以用下面的方式继续关注。
RSS 订阅
按自己的节奏阅读更新没有算法排序,用 RSS 获取新文章,不错过每一次实践更新。
微信公众号·AI 煮代码汤
扫码关注,获取 AI、编程和开发实践的最新分享。