AI 时代,越来越多前端开始转向全栈。对前端来说,Node 是一个很好的切入点:技术栈接近,上手成本更低,也足够实用,能帮我们更快把想法变成可运行的服务,迅速搭出一个 MVP(最小可行产品)。
这篇文章就来认识一下 Node 服务,围绕两个核心问题展开:Node 服务是什么,它是怎么跑起来的;从服务启动到处理客户端请求,中间发生了什么?
一、Node 服务是什么
先说结论:
Node 服务,本质上就是一个长期驻留的 Node 进程。
这个进程通常会做几件事:
- 监听某个端口;
- 接收客户端请求;
- 执行业务逻辑;
- 访问数据库、缓存、第三方服务;
- 把结果返回给客户端。
例如:
const http = require('http')

const server = http.createServer((req, res) => {
  res.end('hello')
})

server.listen(3000)
如果只是执行一段普通脚本,Node 代码跑完就结束了。但如果代码里调用了 server.listen(3000),程序就不会退出,而是会一直运行,等待客户端访问这个端口。这个持续运行、对外提供能力的程序,就是常说的 Node 服务。
可以把它记成一句话:
Node 服务 = Node 进程 + 应用代码 + 可供客户端访问的网络入口
二、Node 进程是什么
很多人在刚接触 Node 时,容易把“代码文件”和“运行中的服务”混在一起。
比如执行:
node app.js这里真正被操作系统启动的,不是 app.js,而是 node。app.js 只是传给 node 的脚本文件。
所以更准确地说,不是“app.js 变成了一个进程”,而是:
操作系统先创建一个 Node 进程,再由这个进程去加载并执行
app.js。
从系统视角看,一个运行中的 Node 进程通常包含这些东西:
- 一个进程 ID,也就是 PID;
- 一块独立的虚拟内存空间;
- 正在执行 JavaScript 的主线程;
- Node 运行时初始化出来的环境;
- 打开的文件描述符;
- 网络连接和监听端口;
- 定时器、回调、未完成的异步任务。
如果这个进程里已经执行了 server.listen(3000),那它就不只是“在跑一段 JS”,而是在作为一个服务进程对外提供能力。
执行 node app.js 时发生了什么
整个过程大致可以拆成这样:
- 在终端输入
node app.js; - 当前 shell 解析命令;
- shell 找到
node可执行程序; - shell 请求操作系统启动这个程序;
- 操作系统创建一个新的进程,并分配 PID、内存、文件描述符等资源;
- 新进程开始运行
node; - Node 初始化运行时环境;
- Node 读取并执行
app.js。
如果 app.js 只是普通脚本,执行完后进程就退出。如果 app.js 里启动了 HTTP 服务、定时器或者还有其他活跃任务,这个进程就会继续存活。
三、Node 运行时提供了什么
JavaScript 本身只是一门语言。如果离开浏览器,单靠语言规范,其实并没有读写文件、监听端口、启动子进程、获取环境变量、直接访问操作系统资源这些能力。
这些能力,是 Node 运行时提供的。也就是说,Node 不只是一个“执行 JS 的工具”,而是一整套服务器端运行环境。
1. 文件系统能力
最常见的是 fs 模块,可以读取、写入和删除文件,创建和遍历目录。
const fs = require('fs')

fs.readFile('./a.txt', 'utf8', (err, data) => {
  console.log(data)
})
2. 网络能力
最常见的是 http、https、net 和 tls:
const http = require('http')

http.createServer((req, res) => {
  res.end('ok')
}).listen(3000)
这意味着 Node 可以直接写 HTTP 服务,而浏览器里的 JavaScript 做不到“自己监听一个端口”。
3. 进程能力
Node 提供 process 和 child_process,可以获取当前进程 PID、环境变量、命令行参数和退出信号。
console.log(process.pid)
console.log(process.env.NODE_ENV)
4. 二进制与流能力
Node 还提供 Buffer 和 stream,用于处理文件传输、网络字节流、图片与音视频,以及大文件上传下载。
5. 定时与调度能力
setTimeout、setInterval、setImmediate 和 process.nextTick 也属于运行时提供的宿主能力。
一句话概括:
Node 做的事,就是把操作系统的一部分能力,包装成 JavaScript API 暴露出来。
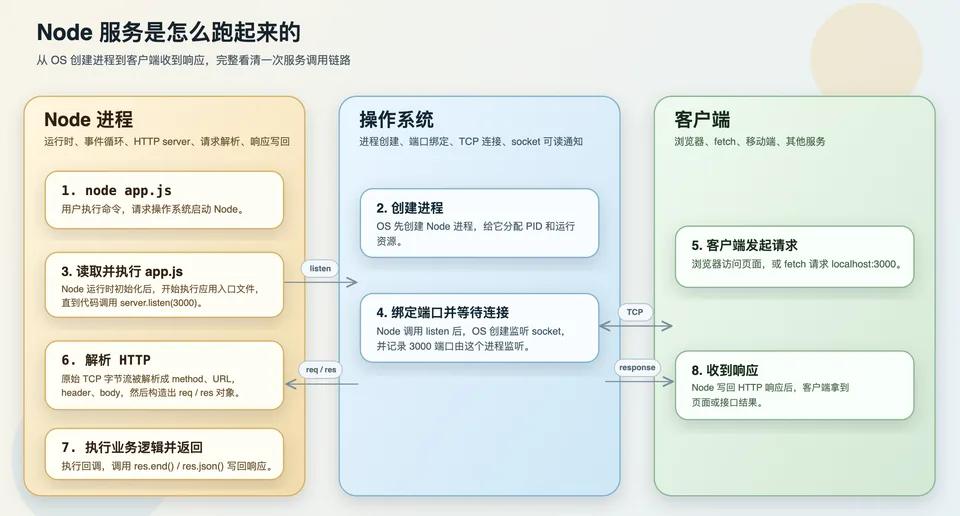
四、从服务启动到处理客户端请求,中间发生了什么
这是理解 Node 服务的关键链路。假设有这样一段代码:
const http = require('http')

const server = http.createServer((req, res) => {
  res.end('hello')
})

server.listen(3000)
当浏览器访问 http://localhost:3000,中间大致会发生下面这些步骤。
第 1 步:Node 启动监听
执行 listen(3000) 后,Node 创建监听 socket,操作系统记录 3000 端口归这个 Node 进程监听,进程进入待命状态。
第 2 步:客户端发起 TCP 连接
HTTP 请求不是直接进入 Node 的,而是运行在 TCP 连接之上。所以顺序不是“先发 HTTP”,而是客户端先和服务端建立 TCP 连接,连接建立后,再发送 HTTP 请求报文。
第 3 步:操作系统接收连接
客户端的数据包到达机器后,操作系统会根据端口号查找:“3000 端口是谁在监听?”查到是这个 Node 进程后,操作系统会接受连接、把连接加入队列,并在连接可读时通知 Node。
第 4 步:Node 收到可读通知
Node 并不是一直死循环检查网络。真正盯着网络的是操作系统,Node 更多是被通知的一方。当操作系统发现有新连接到来,或者某个连接上已经有数据,就会通知 Node 去处理。
第 5 步:Node 读取原始 TCP 字节流
这时 Node 拿到的还不是“漂亮的请求对象”,而是原始网络字节。例如客户端发来的可能是:
GET /user HTTP/1.1
Host: localhost:3000
Connection: keep-alive
本质上它就是一段按 HTTP 协议组织起来的字节流。
第 6 步:Node 解析 HTTP 协议
Node 内部会把这些字节解析成请求方法、URL、请求头和请求体,然后构造出熟悉的 req 与 res。
第 7 步:执行回调
直到这一步,才轮到业务逻辑执行:
(req, res) => {
  res.end('hello')
}
第 8 步:写回响应
当调用 res.end('hello'),Node 会把响应状态行、响应头、响应体拼成 HTTP 响应字节,再通过底层 socket 写回客户端。
整条链路可以总结成一句话:
Node 先把“监听端口、接收连接”交给操作系统,等真正有连接和数据到来时,操作系统再通知 Node,Node 才开始解析 HTTP 并执行应用代码。
五、Node 为什么能同时处理很多请求
Node 的 JavaScript 主执行逻辑通常是单线程的,但它并不等于整个运行时只有一个线程,也不等于一次只能服务一个请求。
业务代码通常运行在主线程上。但在很多 Web 场景里,请求的大部分时间其实不是“在算”,而是在“等”:等数据库、等 Redis、等第三方接口、等网络收发。
这些等待中的 I/O 操作,并不会一直堵住主线程。Node 会在当前请求挂起等待结果时,继续去处理别的事件和请求,等结果返回后,再恢复后续逻辑。
所以,Node 的关键不是“一个请求开一个线程”,而是:
- 发起异步操作;
- 当前请求先挂起;
- 主线程继续处理别的请求;
- 等结果返回后,再恢复后续逻辑。
举个例子
来看一个典型接口:
app.get('/user', async (req, res) => {
  const data = await db.query('select * from user')
  res.json(data)
})
假设此时有两个页面几乎同时请求 /user,把它们分别叫作请求 A 和请求 B。请求 A 到达 Node、进入路由回调并执行到 await db.query(...) 后,Node 把 SQL 发给数据库,当前请求 A 暂时挂起;这时 Node 会继续处理请求 B。请求 B 也执行到 await db.query(...),谁的数据库结果先回来,谁就先恢复执行,分别调用 res.json(data) 返回响应。
这里 await 暂停的是当前请求对应的这段函数逻辑,不是整个 Node 服务。也正因为这样,Node 才能在等待数据库结果时继续处理其他请求。
所以,Node 特别适合 API 服务、BFF 层、网关服务、实时通信和 I/O 密集型业务,因为它把等待网络、等待数据库、等待外部接口的时间都利用起来了。
六、自己运行一个可检查的 HTTP 服务
将下面的代码保存为 server.cjs,再运行 node server.cjs。使用 .cjs 是为了明确按 CommonJS 加载,避免当前项目的模块配置影响 require 示例。
const http = require('node:http');

const server = http.createServer((req, res) => {
  res.setHeader('Content-Type', 'application/json; charset=utf-8');
  if (req.method === 'GET' && req.url === '/health') {
    res.writeHead(200);
    res.end(JSON.stringify({ ok: true }));
    return;
  }
  res.writeHead(404);
  res.end(JSON.stringify({ error: 'Not found' }));
});

server.listen(3000, '127.0.0.1', () => {
  console.log('Listening on http://127.0.0.1:3000');
});
浏览器打开 http://127.0.0.1:3000/health,应看到 {"ok":true};访问 /missing 应收到 HTTP 404。这里只监听本机地址,其他设备无法通过服务器公网 IP 直接访问它。
| 现象 | 说明 | 先检查什么 |
|---|---|---|
| 连接被拒绝 | 还没有收到 HTTP 响应 | 进程是否存活、地址和端口是否一致 |
| 返回 404 | 已连到服务,但没有匹配接口 | 路径与请求方法 |
EADDRINUSE |
监听端口已被占用 | 找到原进程,或换一个测试端口 |
| 所有请求一起变慢 | 可能存在主线程阻塞或资源瓶颈 | 同步大计算、同步文件读写和外部依赖 |
async 或 await 不会把同步的大计算自动移到其他线程。例子中的数据库请求只说明异步 I/O 的等待方式,不能据此认为任何业务都不会阻塞。
HTTP API 参考 Node.js 官方文档。本机服务确认正常后,再按 Nginx 与 systemd 部署流程 把服务交给代理和进程管理器。
七、一句话把整件事串起来
如果把整篇文章压缩成一句话,可以概括为:
当执行
node app.js时,操作系统创建了一个 Node 进程;Node 初始化运行时后执行应用代码;如果代码里调用了listen(3000),Node 就会向操作系统注册一个监听端口;客户端发起 TCP 连接并发送 HTTP 请求后,操作系统通知 Node 读取数据;Node 再把原始字节解析成req/res,执行应用逻辑,最后把响应写回客户端。
这就是一个 Node 服务从启动到处理请求的核心主线。
内容更新:
继续保持连接.
如果这篇文章对你有帮助,可以用下面的方式继续关注。
RSS 订阅
按自己的节奏阅读更新没有算法排序,用 RSS 获取新文章,不错过每一次实践更新。
微信公众号·AI 煮代码汤
扫码关注,获取 AI、编程和开发实践的最新分享。