搞选品和竞品分析的人,对这种场景不陌生:淘宝评论手动翻页,小红书笔记卡在登录和加载,闲鱼同款价格隔一会儿就得刷一次。
写爬虫当然不是不行,但维护起来很麻烦。页面结构一变、验证码一弹、登录态一过,原来跑得好好的脚本,马上就抓不到东西了。
今天这个项目叫 BrowserAct。它让 AI Agent 能直接操作浏览器。淘宝评论、小红书笔记、闲鱼价格这些常见的数据抓取需求,仓库里已经有现成的 AI Skill。如果还不够用,它还提供了 browser-act-skill-forge,可以把自己的网页抓取流程封装成新 Skill。
Github 地址:
https://github.com/browser-act/skills
截至我整理素材时,这个项目大概 4.4k+ Star。仓库里一共有 80 个 SKILL.md,其中 78 个来自 Solutions 目录。
Solutions,78 个现成抓取 Skill
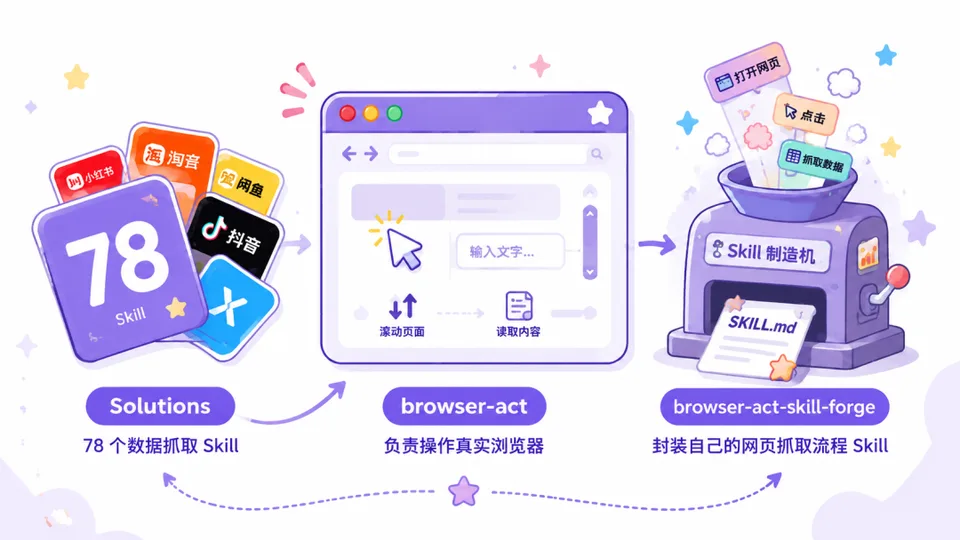
先看 Solutions。它没有停留在「支持数据抓取」这种泛泛的说法,而是拆成了一个个具体网站、具体动作,覆盖电商、获客、搜索与研究、社交监听、视频平台五类场景。
比如大家熟悉的这些:
- 淘宝,关键词搜索、商品详情、评论、店铺目录。
- 小红书,笔记搜索、笔记详情、用户主页、自动发布。
- 闲鱼,商品搜索、商品详情,适合做二手比价和同款监控。
- 抖音 / TikTok,视频详情抓取,适合做内容观察和素材整理。
- 微信文章搜索,把公众号文章检索接进 Agent 工作流。
除了国内平台,Solutions 里也有 Google Maps、LinkedIn、YouTube 字幕和视频信息等 Skill。整体看,它覆盖的是一批高频的网站数据抓取入口。
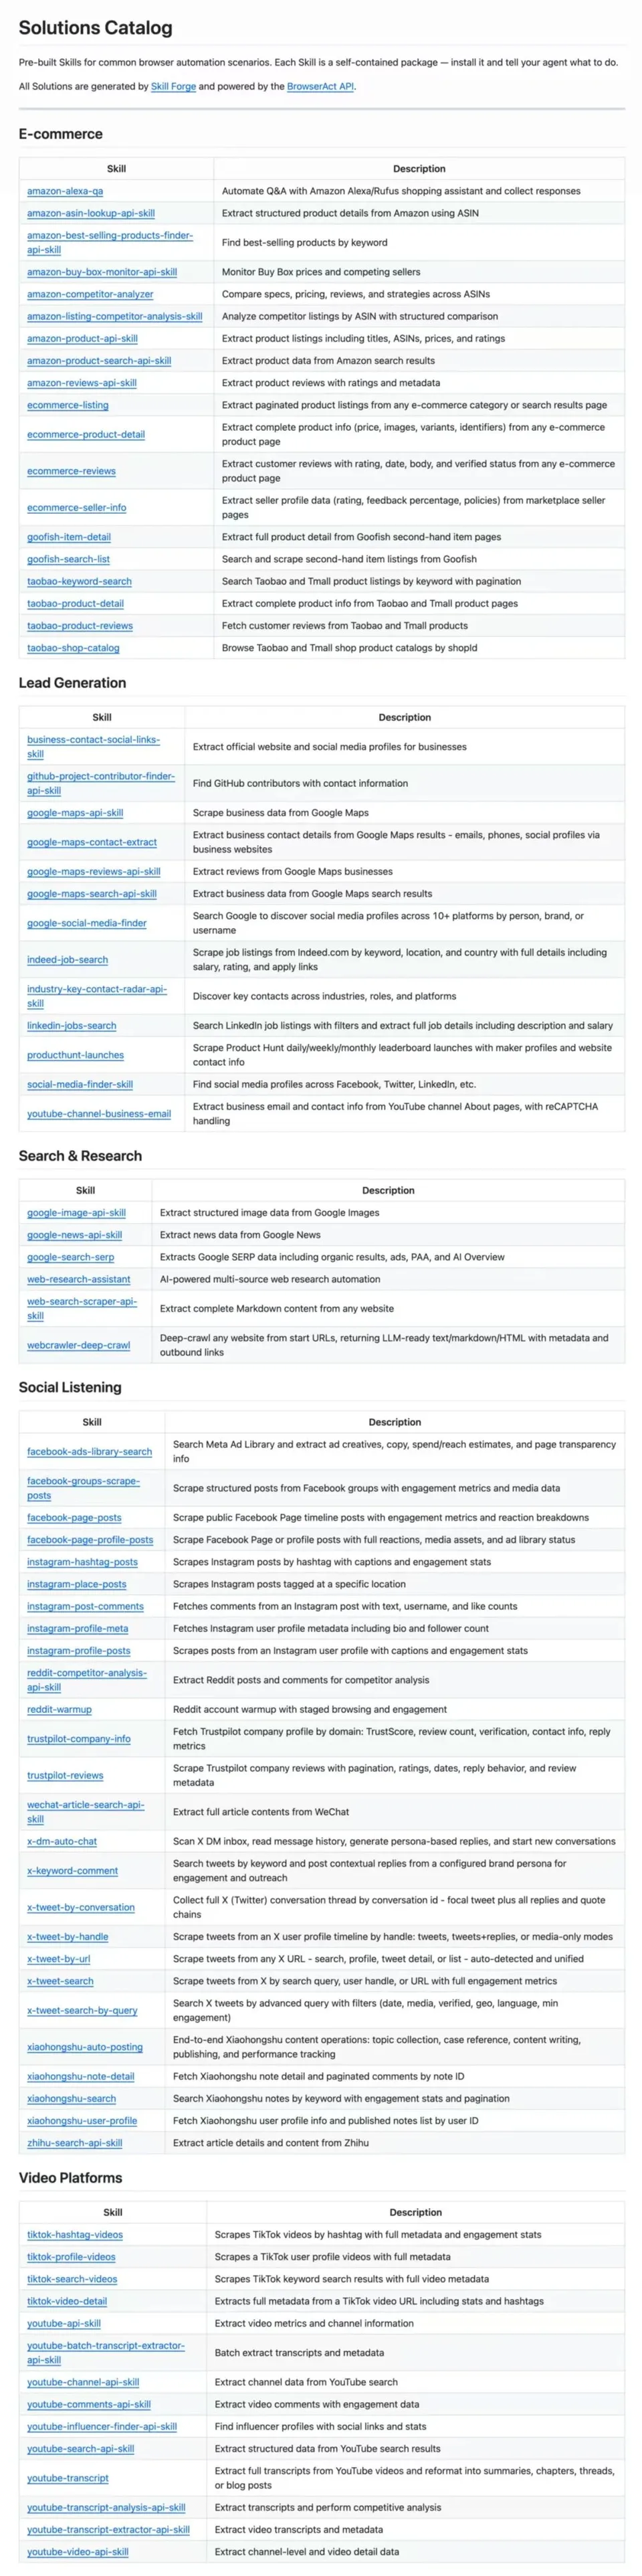
browser-act,负责操作真实浏览器
这些抓取 Skill 要跑起来,先得有人替 AI 稳定操作浏览器。browser-act 做的就是这件事,它让 Claude Code、Codex、Cursor、WorkBuddy 这类 Agent 可以打开网页、点击按钮、输入内容、读取页面状态。
普通爬虫是「写代码请求页面」。browser-act 是「让 Agent 去完成浏览器里的任务」。它面对的是现实网页里的麻烦,比如登录态、动态加载、验证码、按钮点击和页面状态判断。
skill-forge,把自己的流程沉淀下来
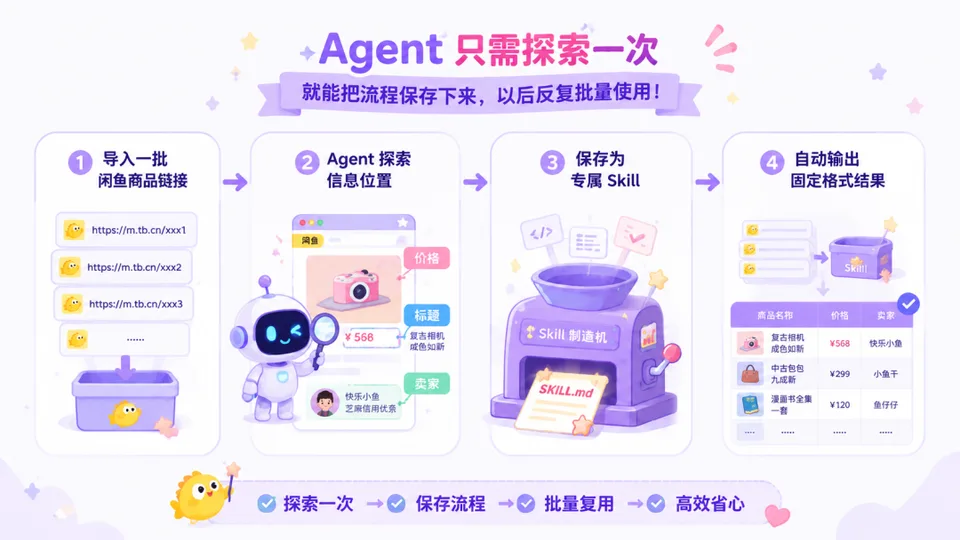
现成的 Solutions 能覆盖一批常见网站,但真实工作里总会有更细的需求。比如你想每天盯 20 个闲鱼链接有没有降价,或者想抓某个垂直网站的榜单、评论和商品详情。
这时候可以用 browser-act-skill-forge。它会让 Agent 先探索一次目标网站,理解页面结构、点击路径和数据位置,再把这套流程沉淀成一个可重复调用的 Skill。
也就是说,Solutions 解决的是常见网站的高频抓取,skill-forge 解决的是你自己业务里的长尾抓取。前者是现成入口,后者是把新流程继续做成可复用能力。
安装和使用
将以下内容按步骤发送给你的 Agent 进行安装即可
第一步,先装 browser-act 这个核心 Skill
它负责告诉 Agent 怎么调用 BrowserAct 的浏览器能力。
帮我安装 browser-act
github 地址:https://github.com/browser-act/skills/tree/main/browser-act
装完验证 SKILL.md 是否存在
第二步,安装 browser-act-cli
真正打开浏览器、维持会话、执行点击和读取页面状态,靠的是它。
帮我安装 browser-act-cli,安装后运行 browser-act --version 验证第三步,按需求安装 Solutions 里的高频抓取 Skill
比如你关心淘宝评论、小红书笔记、闲鱼商品,可以只装自己会用到的几个。
帮我安装 taobao-keyword-search
github 地址:https://github.com/browser-act/skills/tree/main/solutions/ecommerce/taobao-keyword-search
装完验证 SKILL.md 是否存在
常见的国内平台 Skill 大概是这些:
- 淘宝:
taobao-keyword-search、taobao-product-detail、taobao-product-reviews、taobao-shop-catalog。 - 小红书:
xiaohongshu-search、xiaohongshu-note-detail、xiaohongshu-user-profile。 - 闲鱼:
goofish-search-list、goofish-item-detail。 - 视频平台:
tiktok-search-videos、tiktok-video-detail。 - 微信文章:
wechat-article-search-api-skill。
制作自己的流程 Skill
如果现成 Solutions 没覆盖你的目标网站,再装 browser-act-skill-forge。它适合把自己的网页数据采集流程做成新 Skill,比如固定抓某个垂直网站的榜单、商品详情或评论区。
帮我安装 browser-act-skill-forge
github 地址:https://github.com/browser-act/skills/tree/main/browser-act-skill-forge
装完验证 SKILL.md 是否存在。
使用
装好 Skill 之后,你只需要用自然语言告诉 Agent 要做什么。比如已经装了 taobao-product-reviews:
帮我抓一下这个淘宝商品链接的评论,整理成表格。
Agent 会自动调用对应 Skill,打开浏览器、加载页面、抓取数据,最后把结果输出给你。
如果要封装自己的流程,装了 browser-act-skill-forge 之后,可以这样和 Agent 说:
帮我把这个网站的榜单页面探索一遍,找到商品名称、价格、评分的位置,把它做成一个 Skill,以后我传链接就能自动抓。
Agent 会先探索一次网站结构,理解点击路径和数据位置,然后生成一个 SKILL.md 保存下来。之后你再传新链接,它就能按固定格式输出结果。
采集之前,先约定字段、条数和失败处理
以商品评论整理为例,先在有权访问的页面上试取少量数据,再考虑分页。不要只说“抓一下评论”,可以明确交付要求:
先读取我提供的一个商品页面,最多整理 10 条当前可见评论。
字段:来源链接、商品标识、评论标识、评分、评论原文、可见日期。
看不到的字段留空,不根据昵称猜测身份,不自动补写评论。
只保留原页可核对的数据;遇到登录或验证要求时暂停,说明卡点。
输出去重后的表格,并报告实际读到多少条、哪些页失败。
检查结果时,用原链接抽查三条评论;分页需要稳定的评论标识,不能仅按相同文本去重,否则可能合并不同用户的真实评论。拿不到稳定标识时,应记录去重方法和局限。
安装成功只证明工具存在,不证明目标站当前可采集。页面结构、登录态或字段变化后,应重新试取少量样本。只需检索和阅读资料时,可先看 Agent Reach 阅读流程;有正式 API 时,优先按 接口验证清单 选择数据入口。
技能目录与安装入口参考 BrowserAct 官方仓库,现成技能数量会随版本变化。
适合谁,不适合谁
它比较适合这几类人:
- 做电商选品,想看淘宝评论、店铺目录、商品信息。
- 做内容运营,想整理小红书笔记、抖音视频、微信文章。
- 做竞品分析,想定期抓公开页面里的价格、文案和内容变化。
- 做 Agent 工作流,想把重复网页操作沉淀成 Skill。
但它也不是万能的。stealth 可以降低被识别概率,不代表所有网站都能稳定跑;遇到强登录、强风控、扫码、2FA,仍然可能需要人工接管。
写在最后
BrowserAct 值得关注的地方,是它把网站数据抓取拆成了三件事:browser-act 负责真实浏览器操作,browser-act-skill-forge 负责沉淀新流程,Solutions 提供 78 个现成抓取技能。
如果你平时就要处理淘宝、小红书、闲鱼、抖音这类平台的数据,它至少值得收藏一下。下次遇到重复网页任务时,可以先试跑一页并核对结果,再决定是否把流程保存下来复用。
最后提醒一句:本文介绍的 Skill 和工具,仅限用于合法的数据采集需求,比如你自己的店铺数据、公开的竞品分析、个人研究等。抓取他人数据时,请遵守目标网站的 robots 协议和用户协议,不要用于侵权或商业盗用。
内容更新:
继续保持连接.
如果这篇文章对你有帮助,可以用下面的方式继续关注。
RSS 订阅
按自己的节奏阅读更新没有算法排序,用 RSS 获取新文章,不错过每一次实践更新。
微信公众号·AI 煮代码汤
扫码关注,获取 AI、编程和开发实践的最新分享。