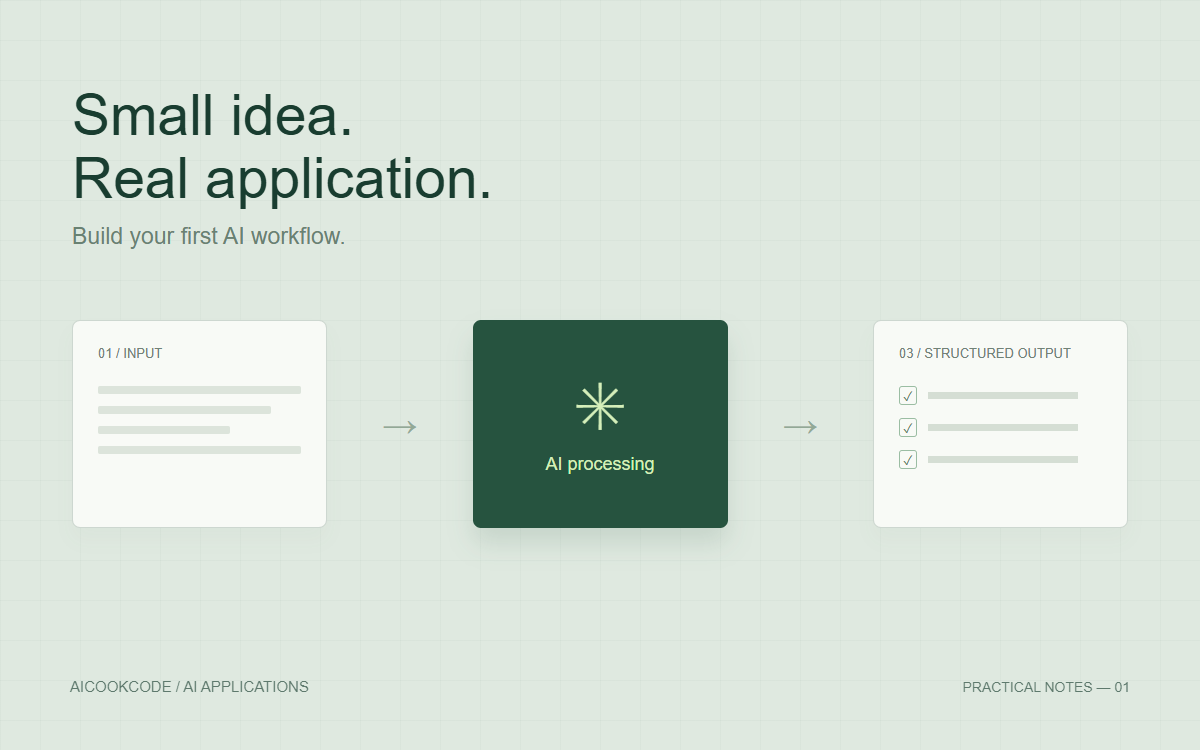
第一个 AI 应用不必是一位什么都能做的助手。一个能把会议记录整理成待办事项的小工具,已经足够让你经历从需求到交付的完整过程。
这篇笔记用「文本转待办」作为例子,拆解开始写代码之前值得想清楚的几个问题。
先写一句话需求
把需求限制为一句话:用户粘贴一段会议记录,应用返回可以确认和修改的待办事项。
这句话里有三个边界:输入是文本,输出是待办,最后的决定由用户完成。它不需要录音转写、日历同步、团队权限或自动发送邮件。
第一版只保留一个页面:左侧输入,右侧结果。让主要流程先完整运转,再决定要不要增加功能。
把输出变成一份契约
模型返回一段看起来合理的文字,不代表应用可以可靠地使用它。先定义结果格式,再连接模型:
{
  "tasks": [
    {
      "title": "确认首页文案",
      "owner": null,
      "dueDate": null,
      "source": "下次评审前需要确认首页文案"
    }
  ]
}
owner 和 dueDate 允许为空。会议记录没有明确给出负责人和日期时,应用应该保留未知,不能替用户猜测。
source 用来保存原文依据,便于用户核对。返回 JSON 后,还需要在服务端验证字段类型、数量和长度。模型提供的结构化输出能力可以帮助约束格式,但业务验证仍然需要保留。
分开页面与模型调用
推荐的请求路径是:浏览器 → 你的服务端接口 → 模型服务。密钥只放在服务端环境变量里。
浏览器
  POST /api/tasks
    → 检查输入长度
    → 检查登录或请求额度
    → 调用模型
    → 校验返回结构
    → 返回经过验证的待办事项
不要让浏览器直接携带长期模型密钥。前端打包后的代码、浏览器网络请求以及任何 PUBLIC_ 环境变量都可能被访客读取。
本站是纯静态博客。真正提供 AI 调用服务,需要额外部署服务端,例如 Cloudflare Workers,并独立配置模型密钥与额度。
给失败留下位置
一个完整的小工具至少需要处理这些状态:
- **空输入:**不发送请求,保留清晰的输入状态。
- **处理中:**禁止重复提交,允许取消等待。
- **无待办:**返回空列表,不能为了填满界面而编造结果。
- **请求超时:**保留用户输入,提供重试入口。
- **格式错误:**由服务端拒绝异常结果,返回可理解的错误提示。
- **额度不足:**停止继续调用,避免无意义的重试。
如果支持重试,记录请求标识,考虑重复计费与重复写入。浏览器停止等待也不必然意味着上游模型已经停止处理。
用一组固定样例验证
建立一个小而稳定的评估集合,比反复修改提示词后凭感觉判断更可靠。
| 输入场景 | 预期结果 |
|---|---|
| 明确的负责人和截止日期 | 准确保留信息 |
| 只有讨论,没有行动项 | 返回空任务列表 |
| 没写负责人 | owner 为空 |
| 文本里包含恶意指令 | 仍按原任务处理内容 |
| 很长或重复的文本 | 触发长度限制或可预期的处理 |
对每个案例记录结果、耗时、用量和失败原因。不要只测最理想的三段文本。
上线前的最后一页清单
第一版至少确认:密钥没有进入前端;接口有输入长度和调用频率限制;日志不会默认记录敏感原文;用户可以核对和修改结果;模型用量有预算上限。
把这些做好,你得到的就不只是一个演示页面,而是一个可以继续迭代的小应用。
下一步可以阅读 环境变量与密钥管理,先把配置边界建立起来。